Power BIでフォルダー内のファイルを一括で読み込む
話すはやさで、文字が流れます
⋄ ⋄ ⋄
それでは続いて、「フォルダー内のファイルを一括で読み込む」操作について学習していきましょう。これは、複数のファイルを一つずつPower BIに取り込むのではなく、指定したフォルダー内にあるファイルをまとめて取り込むテクニックです。
前回は、1つのCSVファイルを読み込みました。しかし、実際の業務では、毎月新しいCSVファイルが作成されるといったケースがあります。たとえば、1月のデータは「2026-01.csv」、2月のデータは「2026-02.csv」、3月のデータは「2026-03.csv」というように、月ごとにファイルが分かれているケースです。
すべてのデータを1つのCSVファイルにまとめてしまう方法もありますが、データ量が増えてくると、ファイル自体が大きくなり、管理や取り扱いが難しくなってしまいます。そこで、データを月単位や年単位などでファイルに分けて管理する方法があります。
たとえば、データ量がそれほど多くなければ、1年単位でファイルを分けてもよいでしょう。一方、毎月大量のデータが発生するのであれば、月単位でファイルを分けるといった方法も考えられます。このように複数のCSVファイルに分かれているデータを、Power BIではフォルダーを指定してまとめて取り込むことができます。
ここで重要なのが、「ファイルを結合する」という考え方です。フォルダーを指定すると、そのフォルダーに保存されている複数のファイルをPower Queryでまとめて取り込み、一つのデータとして扱うことができます。
ただし、この方法を利用する際には、2つ注意しておきたいポイントがあります。
1つ目は、指定したフォルダーに関係のないファイルを置かないことです。Power BIでフォルダーを指定すると、そのフォルダー内にあるファイルを取り込みの対象として扱います。そのため、関係のないExcelファイルや別形式のCSVファイルなどが混ざっていると、それらも取り込もうとしてエラーが発生する可能性があります。
したがって、フォルダーを指定して複数のファイルを取り込む場合は、そのフォルダーには対象となるデータファイルだけを保存するようにしましょう。
2つ目は、ファイル間で列名やデータ構造を統一しておくことです。
複数のファイルを統合する場合は、基本的に「1列目はこの項目、2列目はこの項目」というように、各ファイルの構造をそろえておく必要があります。
たとえば、1月のファイルでは「売上日」「商品名」「売上金額」という列になっているのに、2月のファイルでは「取引日」「商品名」「金額」となっていると、同じデータとして扱うことが難しくなります。また、途中から新しい指標が追加されるなど、ファイルによって列の構成そのものが変わってしまう場合にも注意が必要です。
実際の業務では、システムの変更によって列名が変わったり、新しい項目が追加されたりすることがあります。このような場合は、データを整える作業、いわゆる「データクレンジング」が発生してしまいます。定期的にデータを追加していく仕組みを作るのであれば、元となるローデータの構造をなるべく変更しないことが、安定運用のポイントになります。
それでは、実際に複数のCSVファイルを用意したフォルダーを指定して、データを一括で取り込んでみましょう。
練習データの「02_monthly」フォルダーには、販売実績と同じ列構成で、月ごとに分けた別のCSVファイルが「2022-01.csv」から「2025-12.csv」まで48個入っています。合計で約47,000行と、少しボリュームのあるデータです。ファイルごとに列の構成が同じであることがポイントです。
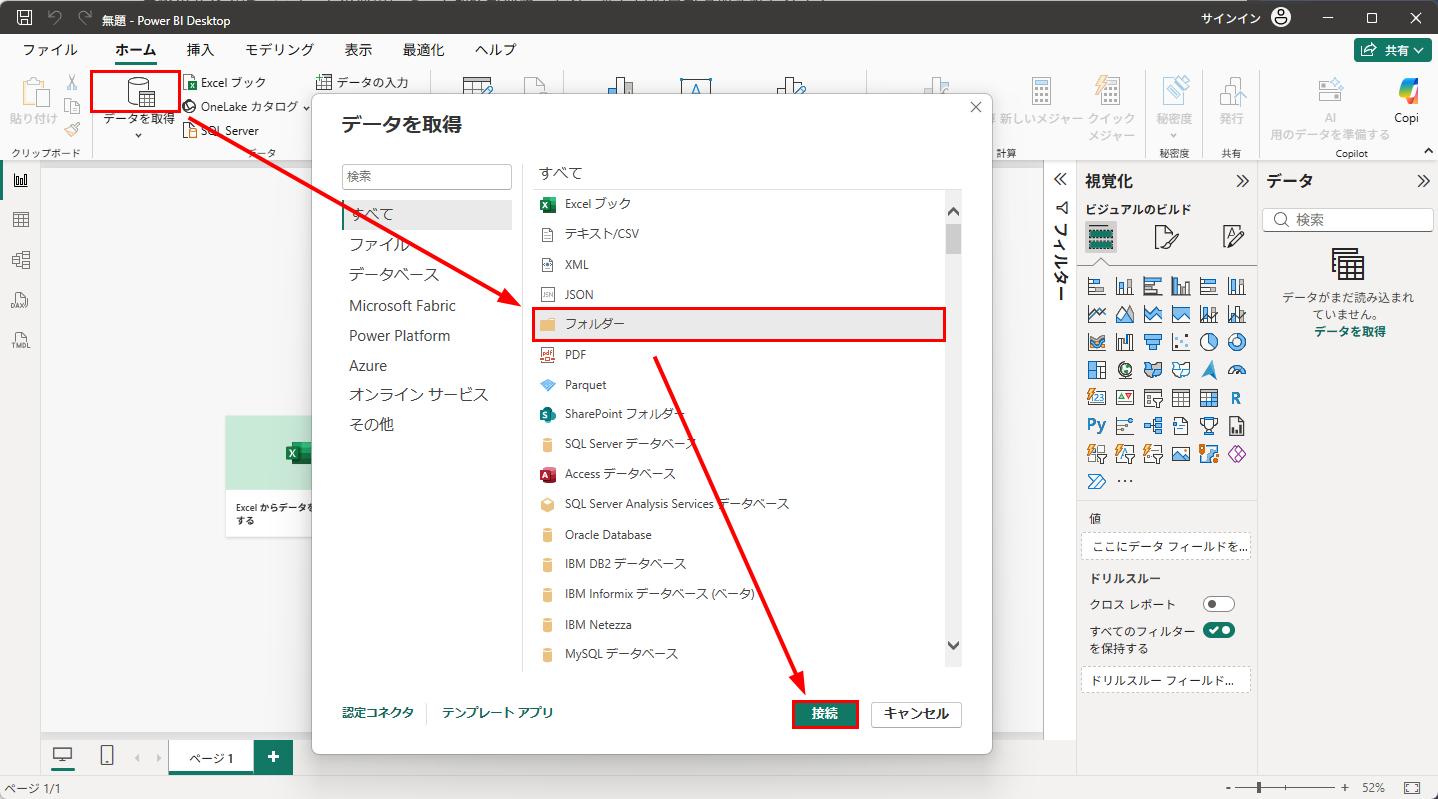
まず、「ホーム」タブの「データを取得」をクリックし、一覧から「フォルダー」を選んで「接続」をクリックします。
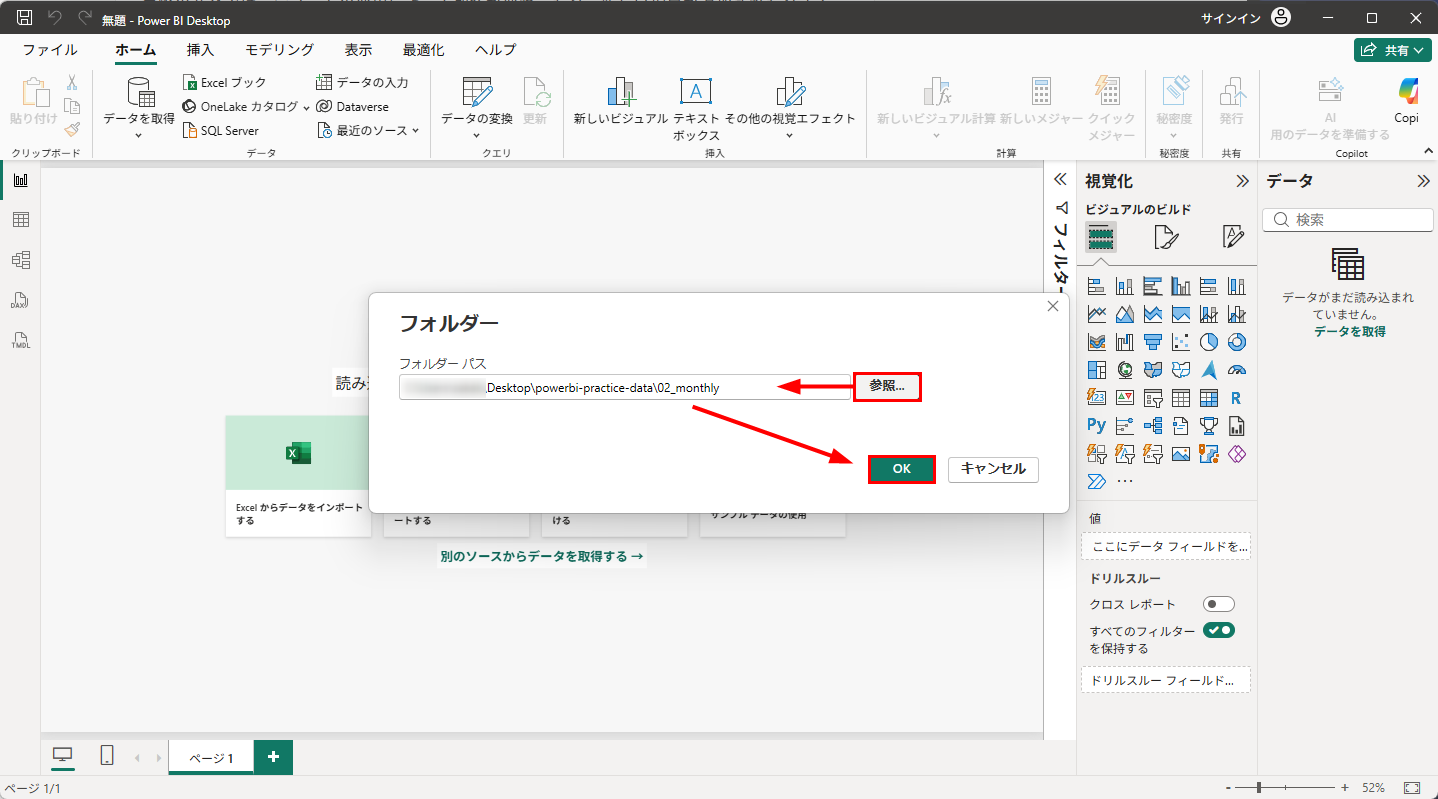
「フォルダー」の画面が表示されますので、「参照」から「02_monthly」フォルダーを指定して、「OK」をクリックします。
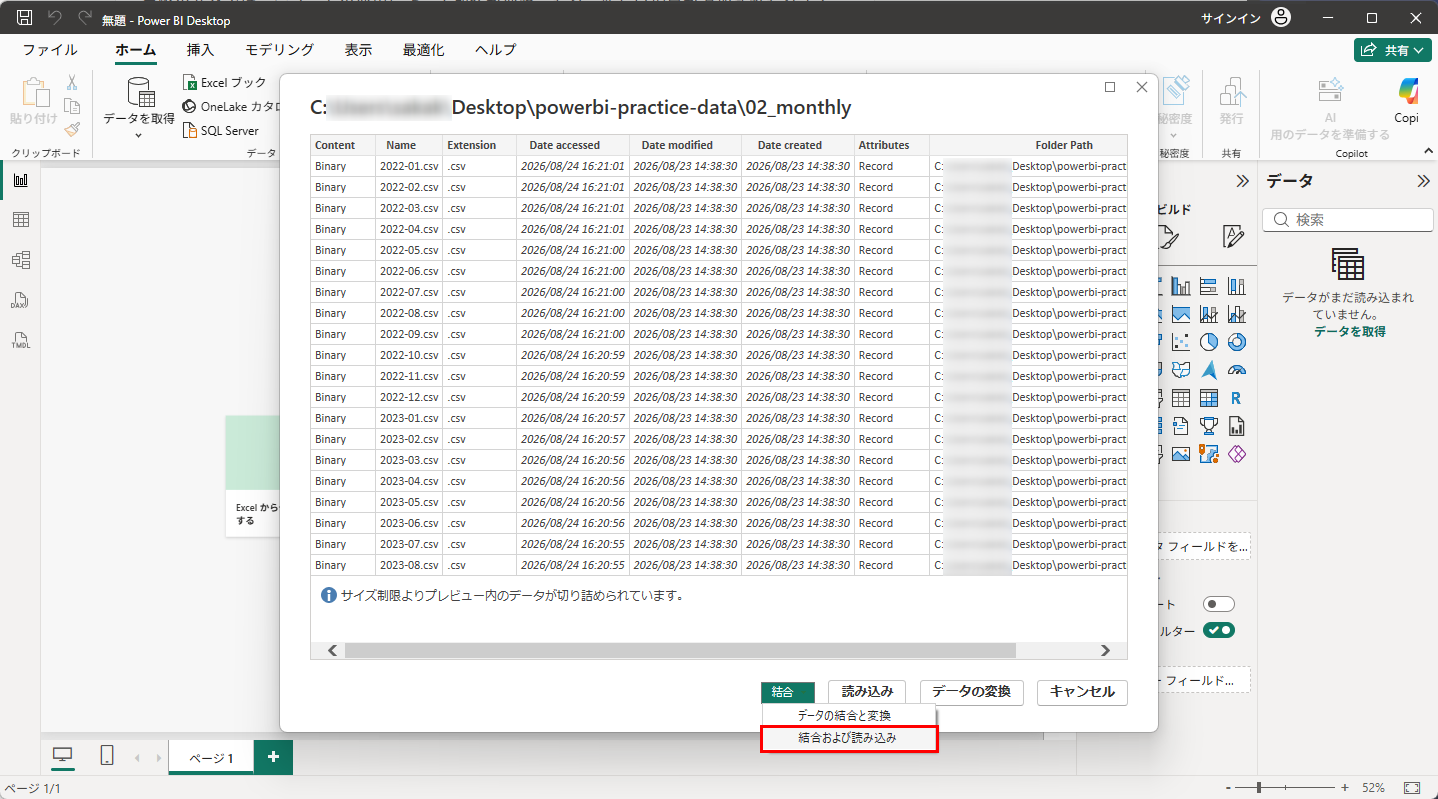
すると、フォルダー内のファイル一覧が表示されます。Name列を見ると、「2022-01.csv」「2022-02.csv」……と、月ごとのCSVファイルが並んでいることが分かります。この時点ではまだ、ファイルの「一覧」を見ているだけで、中身のデータは読み込まれていません。
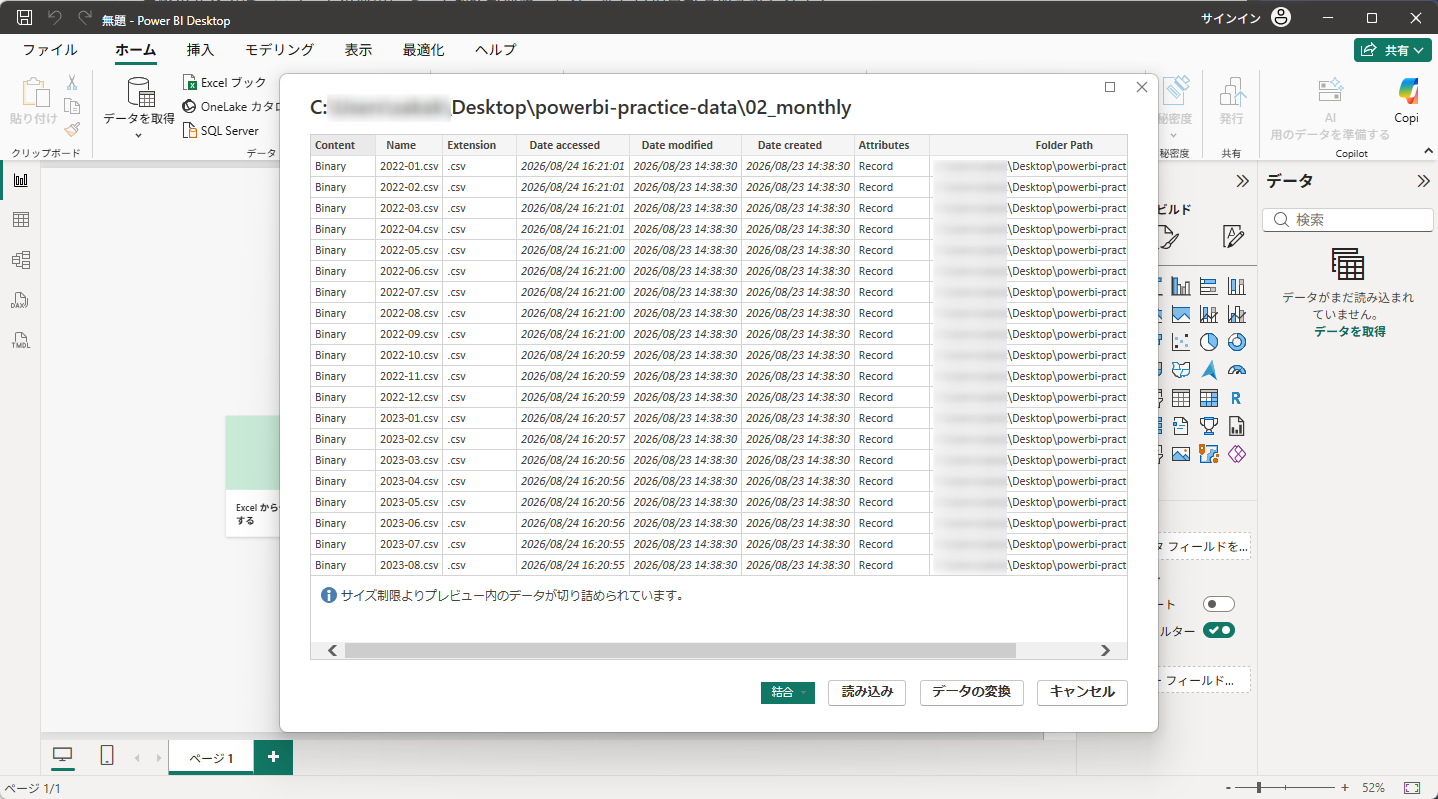
ここで、右下の「結合」ボタンをクリックし、「結合および読み込み」を選びます。これが、複数のファイルを1つにまとめて取り込む操作です。
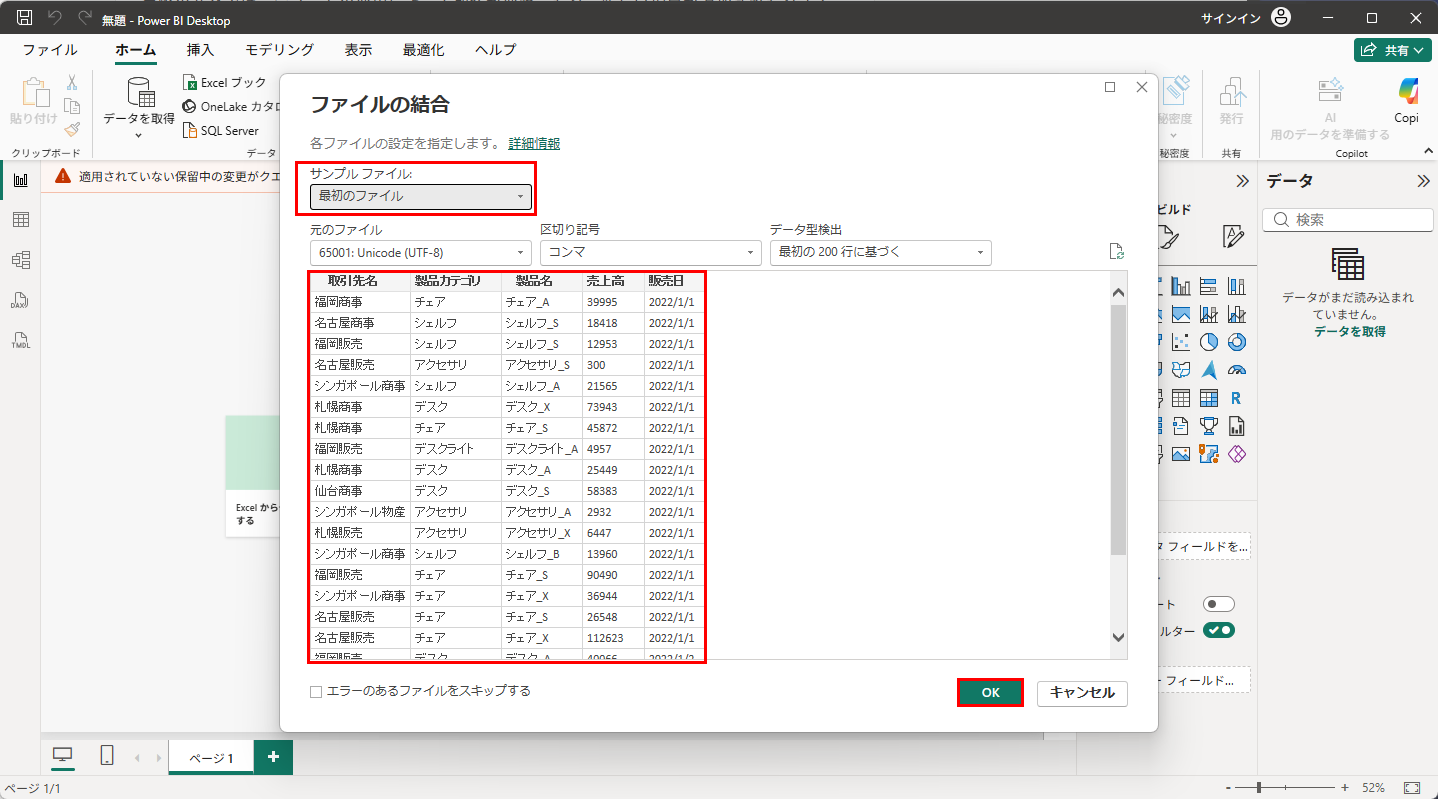
「ファイルの結合」という画面が表示されます。「サンプル ファイル」には「最初のファイル」が選ばれています。Power BIは、この代表となる1つのファイルを見て、「他のファイルも同じ構造だ」という前提で結合します。ここで、フォルダー内のファイルの構造をそろえておくことが大切だった理由が分かりますね。
画面の下には、前回学習した「元のファイル」「区切り記号」「データ型検出」の設定と、サンプルファイルのプレビューが表示されています。列名と内容を確認して、問題なければ「OK」をクリックします。
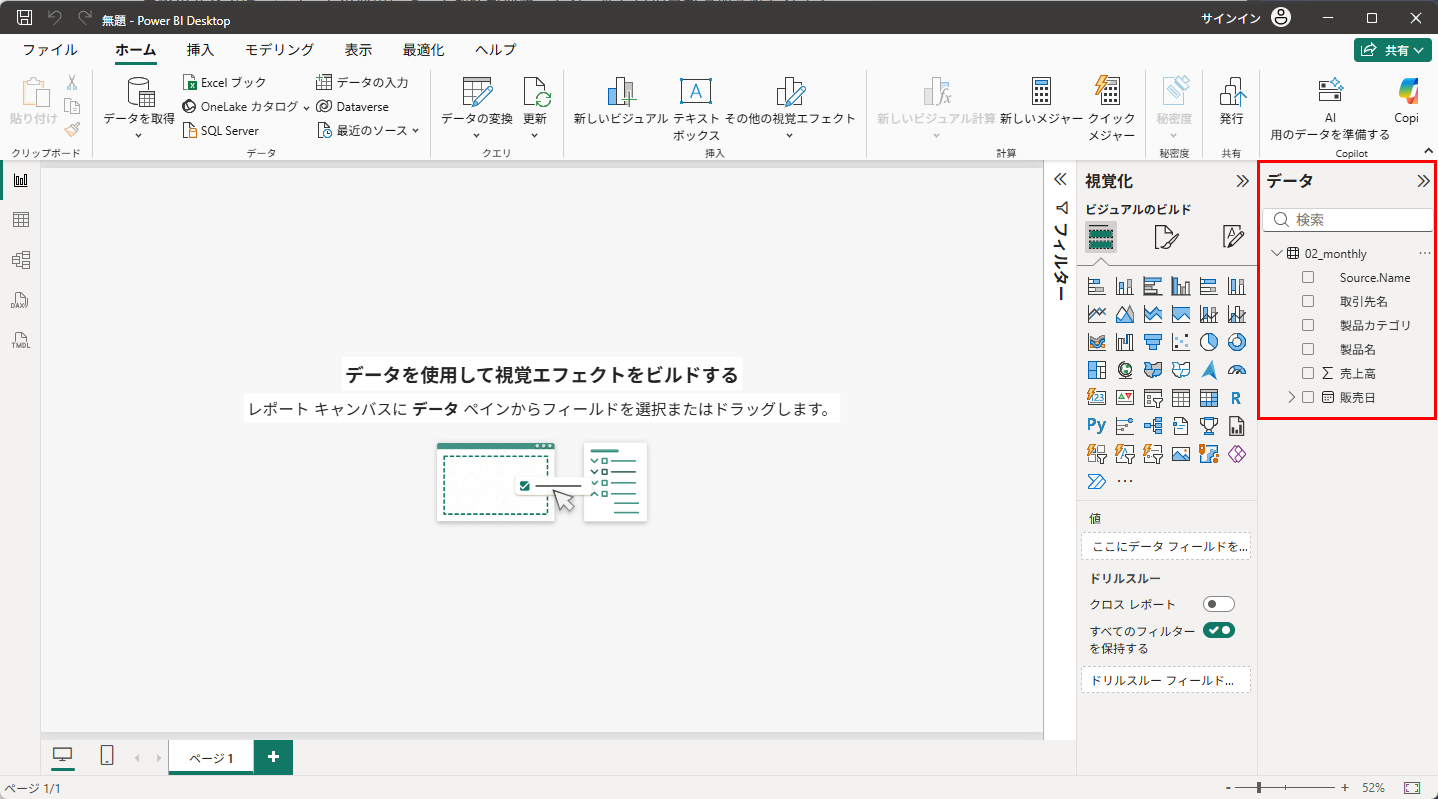
読み込みが終わると、右側のデータウィンドウに「02_monthly」というテーブルが追加されます。テーブル名は、指定したフォルダー名がそのまま使われます。
フィールドを見ると、「取引先名」「製品カテゴリ」「製品名」「売上高」「販売日」に加えて、「Source.Name」という列が増えています。
テーブルビューで中身を確認してみましょう。「Source.Name」列には、その行がどのファイルから読み込まれたのかが入っています。「2022-01.csv」の行が終わると「2022-02.csv」の行が始まる、というように、48個のファイルが縦につながった1つのテーブルになっています。画面の左下を見ると、合計47,204行あることも確認できます。
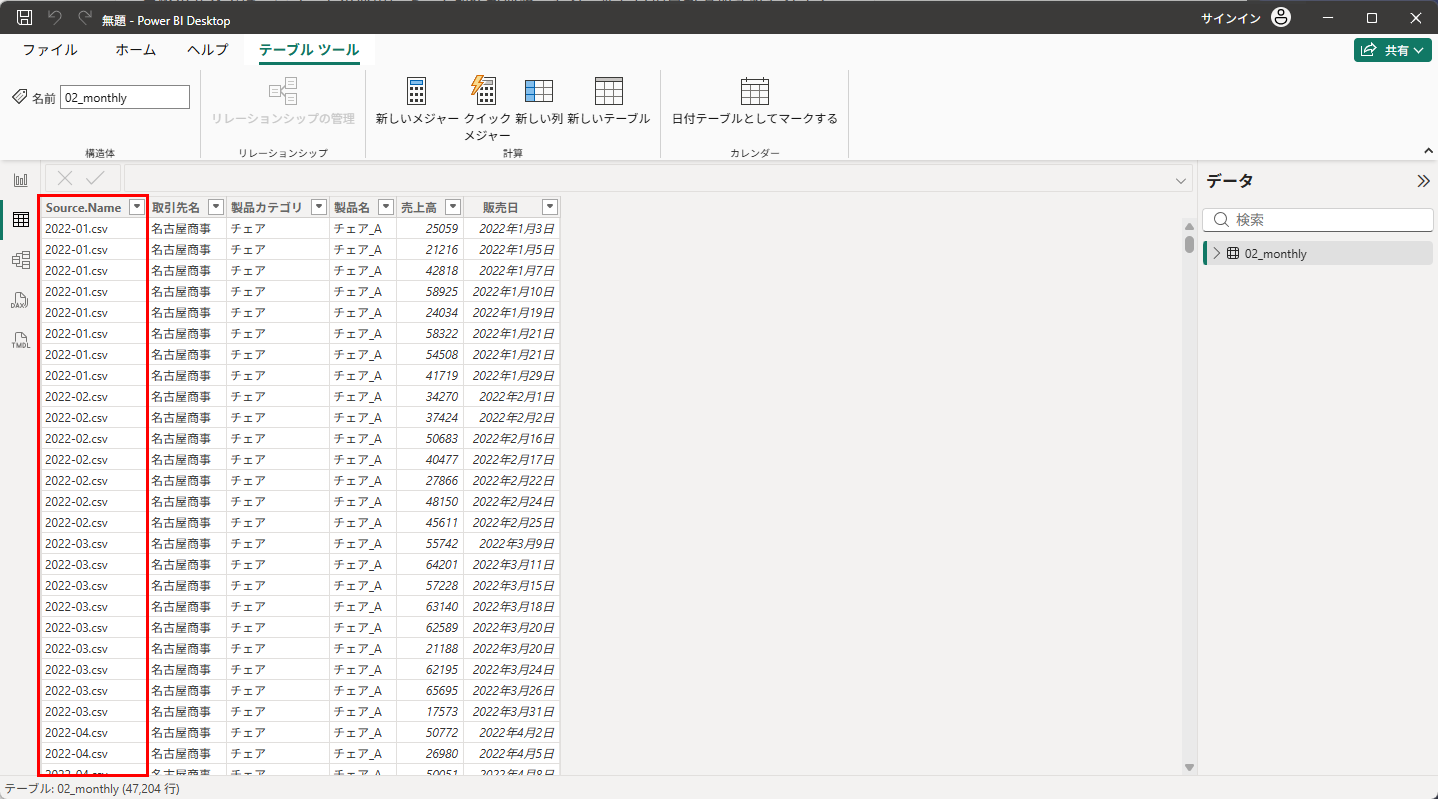
この「Source.Name」列は、どのファイルのデータかを確認するときに便利ですが、分析に使わないのであれば削除しても構いません。
ここまでできれば、あとは通常のテーブルと同じです。そして、翌月のファイルを同じフォルダーに追加したら、「ホーム」タブの「更新」をクリックするだけで、新しいデータが自動的に取り込まれます。
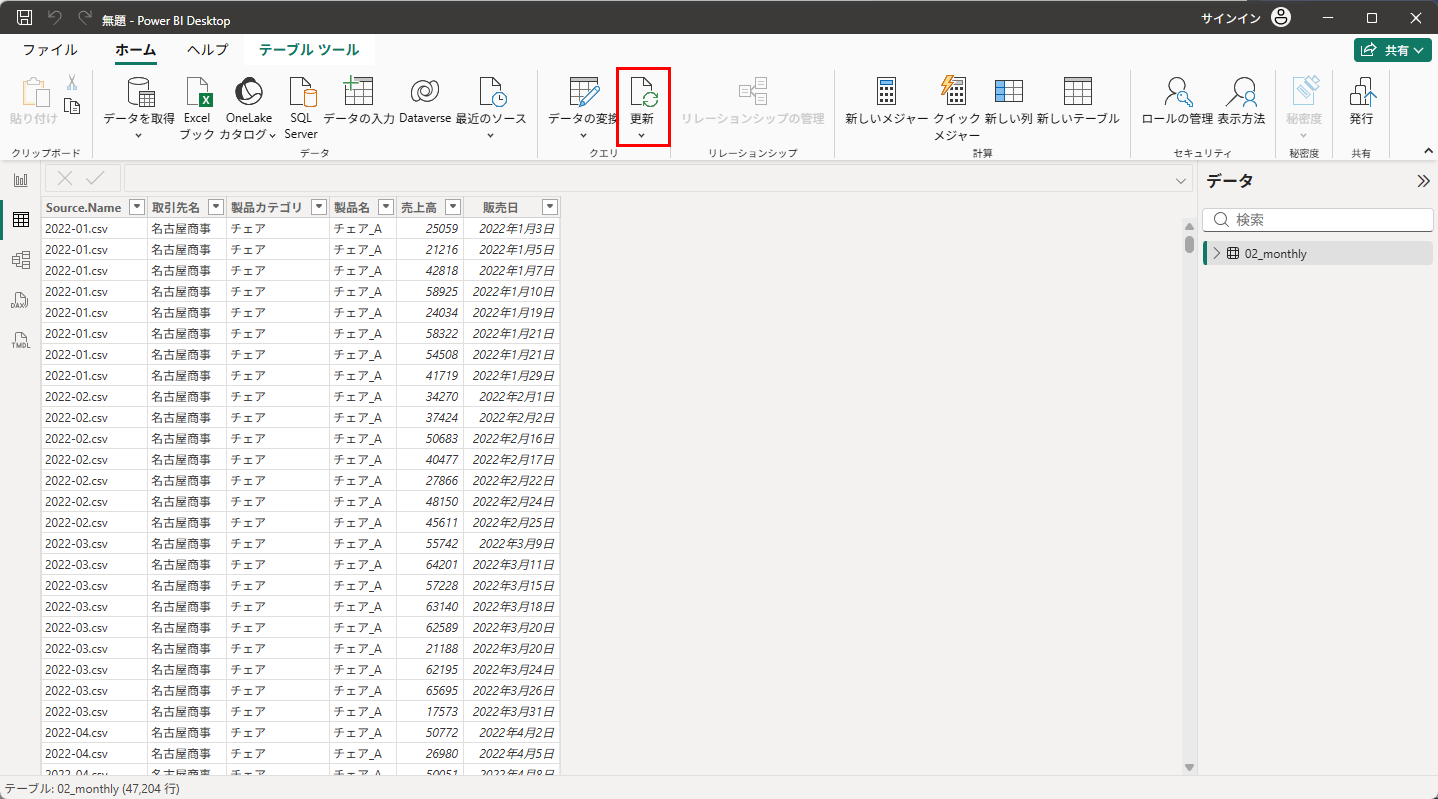
ファイルを追加するたびに取り込み直す必要はありません。これが、フォルダーを指定して取り込むことの一番のメリットです。